wordsim'i geliştirme üzerine
ve sözcük temsillerinin karmaşık dünyası hakkında
Figürlere karanlık modda bakılması önerilir.
wordsim oyununu / projesini yayınlamam üzerinden 1-2 hafta geçti, ve bu süre içerisinde oyunun nasıl ve neden çalıştığı ile ilgili birçok soru aldım. Bu blog yazısı içerisinde bu konulara değinmek ve bu oyunu geliştirme sürecinde kendi kişisel tecrübelerimi de aktarmak istiyorum.
Öncelikle, kısaca kelime gösterimleri1 ve kelimeler arasında benzerlik hesaplama konuları üzerinden geçelim. Genel olarak gösterimlerin detayları hakkında ileride daha fazla yazmayı düşünüyorum ama, bu post içerisinde bu konuyu kısa tutmaya çalışacağım.
İkinci kısımda ise biraz daha teknik bir bakış açısından projenin nasıl geliştirildiğinden ve nasıl çalıştığının üzerinden geçeceğim. Son olarak da, İngilizce ile başlayan bu projeyi Türkçe’ye uyumlu hale getirme sürecinden ve bu süreçte gözlemlediğim bazı ilgi çekici durumlardan bahsedeceğim.
Hazırsak başlayalım.
wordsim ve nasıl çalıştığı hakkında
Neden wordsim?
Bazen çeşitli sebeplerle, örneğin bir konuyu kendine pekiştirmek için basit bir kelime veya sayı tahmin etme oyunu yapmaya karar verirsin. wordsim de aslında bir kelime tahmin etme oyunu olarak böyle bir düşünceden ortaya çıktı.
Biraz daha spesifik olacak olursak, bu proje benim için derin yapay sinir ağları içerisinde sözcük düzeyinde kavramlar ve kavramların arasındaki etkileşimlerin nasıl modellendiğini inceleme isteğimden yola çıkarak başladı. Daha önce CLIP (Radford et al., 2021) gibi görüntü-dil modellerinin gösterimleri konusunda tecrübem vardı, ve ses modalitesinde gösterimleri caz standartları tanıma gibi daha kompleks hedefler için kullanmıştım. Bu projede ise kelime gösterimlerinin geometrisi hakkında çalışmak istedim.
Kelime benzerliği oyunlarının ana mekanizması
wordsim’in de dahil olduğu bu spesifik oyun türü, aslında bir çocukluk dönemi klasiği olan “sıcak-soğuk” oyunundan geliyor. Hatırlarsanız, o oyunda bir kişi bir ortama bir nesneyi gizler, nesneyi bulmak isteyen diğer oyuncu tahminde bulunduğu zaman da objeyi saklayan oyuncu “sıcak” ve “soğuk” gibi ipuçları vererek diğer oyuncuyu gizli nesneye doğru yönlendirirdi.
Bu konsepti çok doğal bir şekilde bir kelime tahmin etme oyununa dönüşebiliriz: ilk oyuncu bir nesneyi saklamak yerine bir kelimeyi düşünür, diğer oyuncu kelimeyi bulmak için tahminlerde bulundukça da saklayan oyuncu anlam olarak yaklaşma derecesine (semantic similarity) göre “sıcak” ve “soğuk” gibi ipuçları vererek kelime bulunana kadar ikinci oyuncuyu yönlendirir. wordsim de tam olarak bu oyuna karşılık gelmekte.

Tabii bu fikir, internette araştırıldığında pek de özgün bir düşünce değil: bu şekilde Contexto, Semantle, ve muhtemelen nice başka anlam-odaklı kelime tahminleme oyununa ulaşmak mümkün. Bu amaca sahip bir Türkçe odaklı kelime benzerliği oyununa daha önce karşılaşmadım (varsa alıntılamak isterim!), bu projenin belki bu açıdan küçük ama özgün bir katkısı bulunabilir.
Her şekilde, wordsim oyununu geliştirebilmek için iki ana detayı düşünmemiz gerekiyor:
- Kelimeleri temsil etmenin bir yolunu bulmalıyız.
- Elimizdeki bir kelimeden, benzer kelimeleri bulmanın ve benzerliklerini hesaplamanın bir yolunu düşünmeliyiz.
Bir sürpriz yapıp önce listedeki ikinci madde ile başlayalım.
Kelime benzerlikleri hakkında düşünmece
Elimizde bir kelime olduğunu varsayalım, ona benzer kelimeleri (“sıcak” diyeceğimiz kelimeleri) nasıl belirleyebiliriz? Sıfırdan başlayıp bazı basit düşüncelerden ilerleyelim:
-
“orman” kelimesi bize “ağaç” kelimesini hatırlatır, çünkü ormanlar ağaçlardan oluşur. Genel olarak “sahip olma”, “üyesi olma”, veya birbiri yerine kullanılabilir kelimeler doğal olarak yüksek benzerlik taşırlar.
-
Bir hedef kelimeye ulaşmanın birden fazla yolu olmalı. “Ay” kelimesine güneş sistemi ve gezegenlerden giderek de ulaşabiliriz, yıl ve gün gibi zaman konulu kavramlardan da kendisine ulaşmak mümkün. İki yol birbirine bağlı olmasa da bizi “ay” hedefine benzerlik aracılığıyla götürmeli.
-
Benzerlik bir miktar geçişlilik göstermeli. Eğer biz sadece hedef kelimeye yakın kelimelere benzerlik skoru verirsek, rastgele bir kelimeden başlayarak hedefimizin komşularına yaklaşmamız oldukça zor olur. Hedef kelimemiz “yumurta” ise “tavuk” kelimesinin yakın olmasını bekleriz, “tavuk” kelimesine ise “tüy” kelimesi yakın olmalı: böylece “yumurta” ve “tüy” arasında, aradaki “tavuk” kelimesini çağrıştırmalarından dolayı bir benzerlik olmalı.
Yukarıdaki listeyi daha da büyütebiliriz, ancak bu şekilde bütün bu gereksinimleri elimizle belirlemek mümkün değil. Maalesef çok fazla ve çok spesifikler, onun yerine bu tarz ilişkileri kendiğinden öğrenen bir sistem tasarlamayı tercih ederiz.
Bu konuda şanslıyız, çünkü bu konu bizi makine öğrenmesindeki doğal dil işleme (NLP) alanına doğru yönlendiriyor. Yeterince veri ve uygun bir model sayesinde bu kuralları doğrudan veriden öğrenen bir sistem inşa edebiliriz.
Atladığımız ilk maddeye geri dönelim.
Kelimeleri nasıl temsil edebiliriz?
En temelden başlayarak, modelimizin kelimeleri tanıyıp kullanabilmesi için bir yöntem bulmamız gerekiyor. Doğal dil işlemedeki geleneksel yöntem, “one-hot encoding” (one-hot kodlama) dediğimiz seyrek gösterimler oluşturma şeklindeydi. Kabaca şu şekilde çalışıyordu:
- Topladığımız metinsel veride geçen bütün kelimeleri alalım. Örneğin 8 kelime topladıysak, bu bizim kelime dağarcığımızı (vocabulary) oluştursun.
- Bu şekilde topladığımız kelimeler için bir sıralama oluşturalım, her kelimenin kendine özel bir indeksi olsun.
- Veri kümemizdeki bütün kelimeleri, kendi indeksi
1ve diğer boşluklar0olacak şekilde0lar ve1ler serisi olarak temsil edelim. Buna “one-hot encoding” adı veriliyor.
Bu aşamada kelimeleri normalize etme, filtreleme, ve sözlük-dışı kelimeleri tespit etme gibi aşamaları genel fikri tanıtma amacıyla şimdilik atlayabiliriz. Küçük bir örnek üzerinden gidelim:
docs = [
    ['this', 'is', 'a', 'dog'], # veri kümesinden örnek bir cümle
    ['cat', 'and', 'dog'],
    ['a', 'mouse'],
    ['cat', 'and', 'mouse', 'game']
]
words = set()
for doc in docs:
    for word in doc:
        words.add(word)
vocab = sorted(list(words))
print(vocab) # ['a', 'and', 'cat', 'dog', 'game', 'is', 'mouse', 'this']
Yukarıdaki kod parçası verimizin üzerinden geçip basit bir kelime dağarcığı oluşturup kelimeleri temsil etmekte kullanacağımız sıralamayı belirliyor.
Bu şekilde kelimelerimizi yerlerine bakarak 0 ve 1ler cinsinden yazabiliriz:
print(onehot(vocab, 'cat'))   # [0, 0, 1, 0, 0, 0, 0, 0]
print(onehot(vocab, 'mouse')) # [0, 0, 0, 0, 0, 0, 1, 0])
Kelimeleri bu şekilde temsil ederek aslında güzel şeyler başarabiliriz. Bir cümleyi, içindeki kelimelerin toplamı şeklinde (kelime torbası / “bag of words”) şeklinde modelleyebilir, veya bu kelimeleri teker teker bir yapay sinir ağına besleyerek sıradaki kelimeyi tahmin etme veya cümle duygu analizi gibi görevler için kullanabiliriz.
Ancak bu sözcük gösterimi seçeneğinin bir sorunu var. Ne olduğunu tahmin edebiliyor musunuz?
Neden one-hot encoding ideal değil?
Kelimeleri one-hot kodlama şeklinde temsil ettiğimiz zaman, $\lvert V \rvert$ adet elemana sahip olan bir $V$ kümesi içerisinde yer alan her kelime, ayrık bir $\lvert V \rvert$-boyutlu uzay içerisinde yer alır ve bu kelimeye ait bütün boyutlar ya 1 (kendi yönü) ya da 0dır (diğer yönler). Bu sebeple bütün her kelime gösterimi $w$ için norm $\lVert w \rVert = 1$ ve herhangi iki kelime gösterimi $w_{i}, w_{j}$ arasındaki Öklid mesafesi
olup kelime çifti seçiminden bağımsız olacak şekilde aynıdır. Geometrik olarak, bütün kelimeler birbirinden aynı uzaklıkta olan yüksek boyutlu bir küre üzerindeler. Yani özetle, bu kelime uzayında mesafe ayrık ve herhangi bir anlam taşıma niteliğine sahip değildir.

Tahmin edeceğiniz üzere bu bizim anlam-bazlı kelime tahmin etme oyunumuz için çok iyi bir işaret değil. Daha iyi bir çözüm bulabilir miyiz?
Sürekli kelime temsilleri ve word2vec
Tam bu noktada Bengio ve ekibinin “A Neural Probabilistic Model” (Bengio et al., 2003) makalesi yardımımıza koşuyor. Bu makale, bu literatürde yapay sinir ağlarını dağıtılmış kelime gösterimleri (distributed word embeddings2) öğrenecek şekilde eğitme açısından önemli bir yol gösterici niteliktedir: bu sayede kelimeler ayrık, aşırı yüksek boyutlu bir uzay yerine sürekli ve daha az boyutlu bir uzayda birer yoğun vektör olarak yer alıyor. Bu yöntem çıktığı dönemde anında kelime temsilleri öğrenme açısından standart yöntem haline gelmese de, günümüzde dil modelleme alanının temelini oluşturuyor.
Ne avantajı var ki?
Sürekli kelime temsilleri ile artık kelimeleri görece daha küçük ama anlama duyarlı bir uzay içerisinde birer yön olarak temsil edebiliyoruz.
- Her kelime için yeni bir boyuta ihtiyacımız yok, ve bu üzerinde aslında çok durmadığımız ama kritik olan “boyutluluk laneti” (curse of dimensionality) problemi ile baş etmemize yardımcı oluyor.
- Bu şekilde kelime temsili öğrenen bir model, temsil uzayı içerisinde benzer kelimeleri birbirine daha anlamsal açıdan yakın yönler olarak öğrenme fırsatına sahip oluyor.
- Bu kelime temsillerini yapay sinir ağlarındaki en temel parametre güncelleme yöntemi olan “geri yayılım” (backpropagation) ile öğrenmek mümkün.
- Son olarak, bu gösterim sayesinde $w_{1}$ ve $w_{2}$ gibi iki rastgele kelime temsili arasında basit kosinüs benzerliği kullanarak ucuz bir şekilde benzerlik hesaplayabiliyoruz:
Bu çalışma bu yazıyı ele aldığımda 20 seneden daha eski olsa da, 2013’teki basit ve verimli kelime temsilleri öğrenme temalı word2vec yöntemlerinin tanıtıldığı, “Efficient Estimation of Word Representations in Vector Space” (Mikolov et al., 2013) çalışmasına kadar sürekli kelime gösterimi yöntemi yükselişe geçmiyor.
word2vec ile öğrenilen vektörlere bakıldığında sürekli kelime temsillerin çok ilginç bir özelliğini görebiliyoruz. Bu konuda king - man + woman = queen örneği, bu şekilde yapılabilecek “kelime aritmetiği” ile alakalı en ünlü örnek olsa gerek:

Ana konumuz olan wordsim’e geri dönecek olursak, bu bizim kelime temsil etme ve ucuz benzerlik hesaplama ihtiyaçlarımızı karşılama açısından çok güzel bir gelişme.
Modern kelime temsilleri
2017’den itibaren doğal dil işleme alanı inanılmaz ölçüde değişti.
- Transformer mimarisi (Vaswani et al., 2017) bu alanda ortaya çıkıp tamamen doğal dil işleme alanını (ve görsel tanımayı, açıkçası bütün alanları) verimliliği ve devasa boyutlara ulaşan veri kümelerini öğrenebilme kapasiteleri açısından tamamen değiştirdi.
- Devasa ölçeklerde büyütülen GPT (Radford et al., 2018) ailesi ve BERT (Devlin et al., 2019) ailesi Transformer modelleri birçok dil işleme görevinde çok yüksek başarıma ulaştı.
Genel olarak, modern büyük dil modelleri (large language models, LLM) kelimeler ve cümleleri tokenize edip bu tokenleri cümledeki mevcut bağlama göre işleyerek görece sabit olan word2vec vektörlerine kıyasla daha zengin bir gösterime dönüştürme gücüne sahiptir. Ancak LLMler genelde cümle seviyesinde girdiler ve görevler için eğitilmekte, burada wordsim ise yalnızca bireysel kelime temsillerini kullanmaktadır.
Şu anda wordsim, İngilizce bulmacalar için arka planda Transformer-bazlı, genel kullanıma uygun kelime temsilleri öğrenme amacına sahip bir model kullanıyor. Bu sayede iki yöntem ailesinden de yararlanmayı amaçlıyoruz.
Teorik kısmın desteğiyle de birlikte, artık her şeyin nasıl çalıştığını incelemeye geçebiliriz.
wordsim nasıl geliştirildi?
wordsim çevrimdışı bir bulmaca (puzzle) üretme modülü ve çevrimiçi bir şekilde bulmacaları servis edecek çevik bir TypeScript-bazlı önyüz (frontend) içeriyor. Kodu açık kaynak olarak kendi GitHub projesinde yer alıyor.
Bulmaca üretme modülü ve süreci
Bulmaca üretici modülün görevleri arasında hedef bir kelime dağarcığı belirleme, bu kelimeleri işleyip dil kurallarına göre filtreleme, kelime gösterimlerini üretip bulmacalarda kullanmak üzere saklama gibi görevler var. Basit bir akışa sahip olup zincirleme işlemler olarak şu şekilde tanıtılabilir.
graph TB
    A[1. Oyun sözlüğü için aday kelimeler belirleme] --> B[2. Kelimeleri uygun formata işleme ve filtreleme] --> C[3. Kelime gösterimlerini üretme] --> D[4. Sözlük temsillerini belirleyip saklama]
Bu aşamaların hepsi aslında oldukça basit.
- wordfreq sayesinde İngilizce ve Türkçe gibi dillerdeki sık kullanılan kelimeleri bulmak oldukça pratik. Örneğin, İngilizce bulmacalar için yaklaşık 30000 kelimelik bir dağarcık keyifli bulmaca üretmek için yeterli çeşitliliğe sahip.
- LLMler özellikle İngilizce dilinde eğitildikleri tonlarca veri ve İngilizce-odaklı hedef görevler sebebiyle İngilizce kelime temsillerinde iyi öğrenilmiş gösterim geometrilerine sahip, bu da anlamsal olarak uygun komşular üretme açısından çok faydalı.
- Spesifik olarak, gösterim üretme odaklı Google’ın EmbeddingGemma ve Qwen’in Qwen3-Embedding gibi gösterim üretme modelleri kullanarak ilginç bulmacalar oluşturabiliyoruz. Bu düşünceyi oyuncu yorumlarına bakarak İngilizce bulmacalar üzerinde desteklemek mümkün.
Bir defa hesaplandıktan sonra bir kelimenin kendi gösterimi değişmeyeceği için, bütün gösterimleri dondurup verimli bir kelime -> gösterim tablosu şeklinde saklayabiliyoruz.
Görsel açıdan, UMAP yöntemini kullanarak modelin öğrendiği uzayın kabaca iki boyuta indirgenmiş bir şekilde inceleyebiliriz:
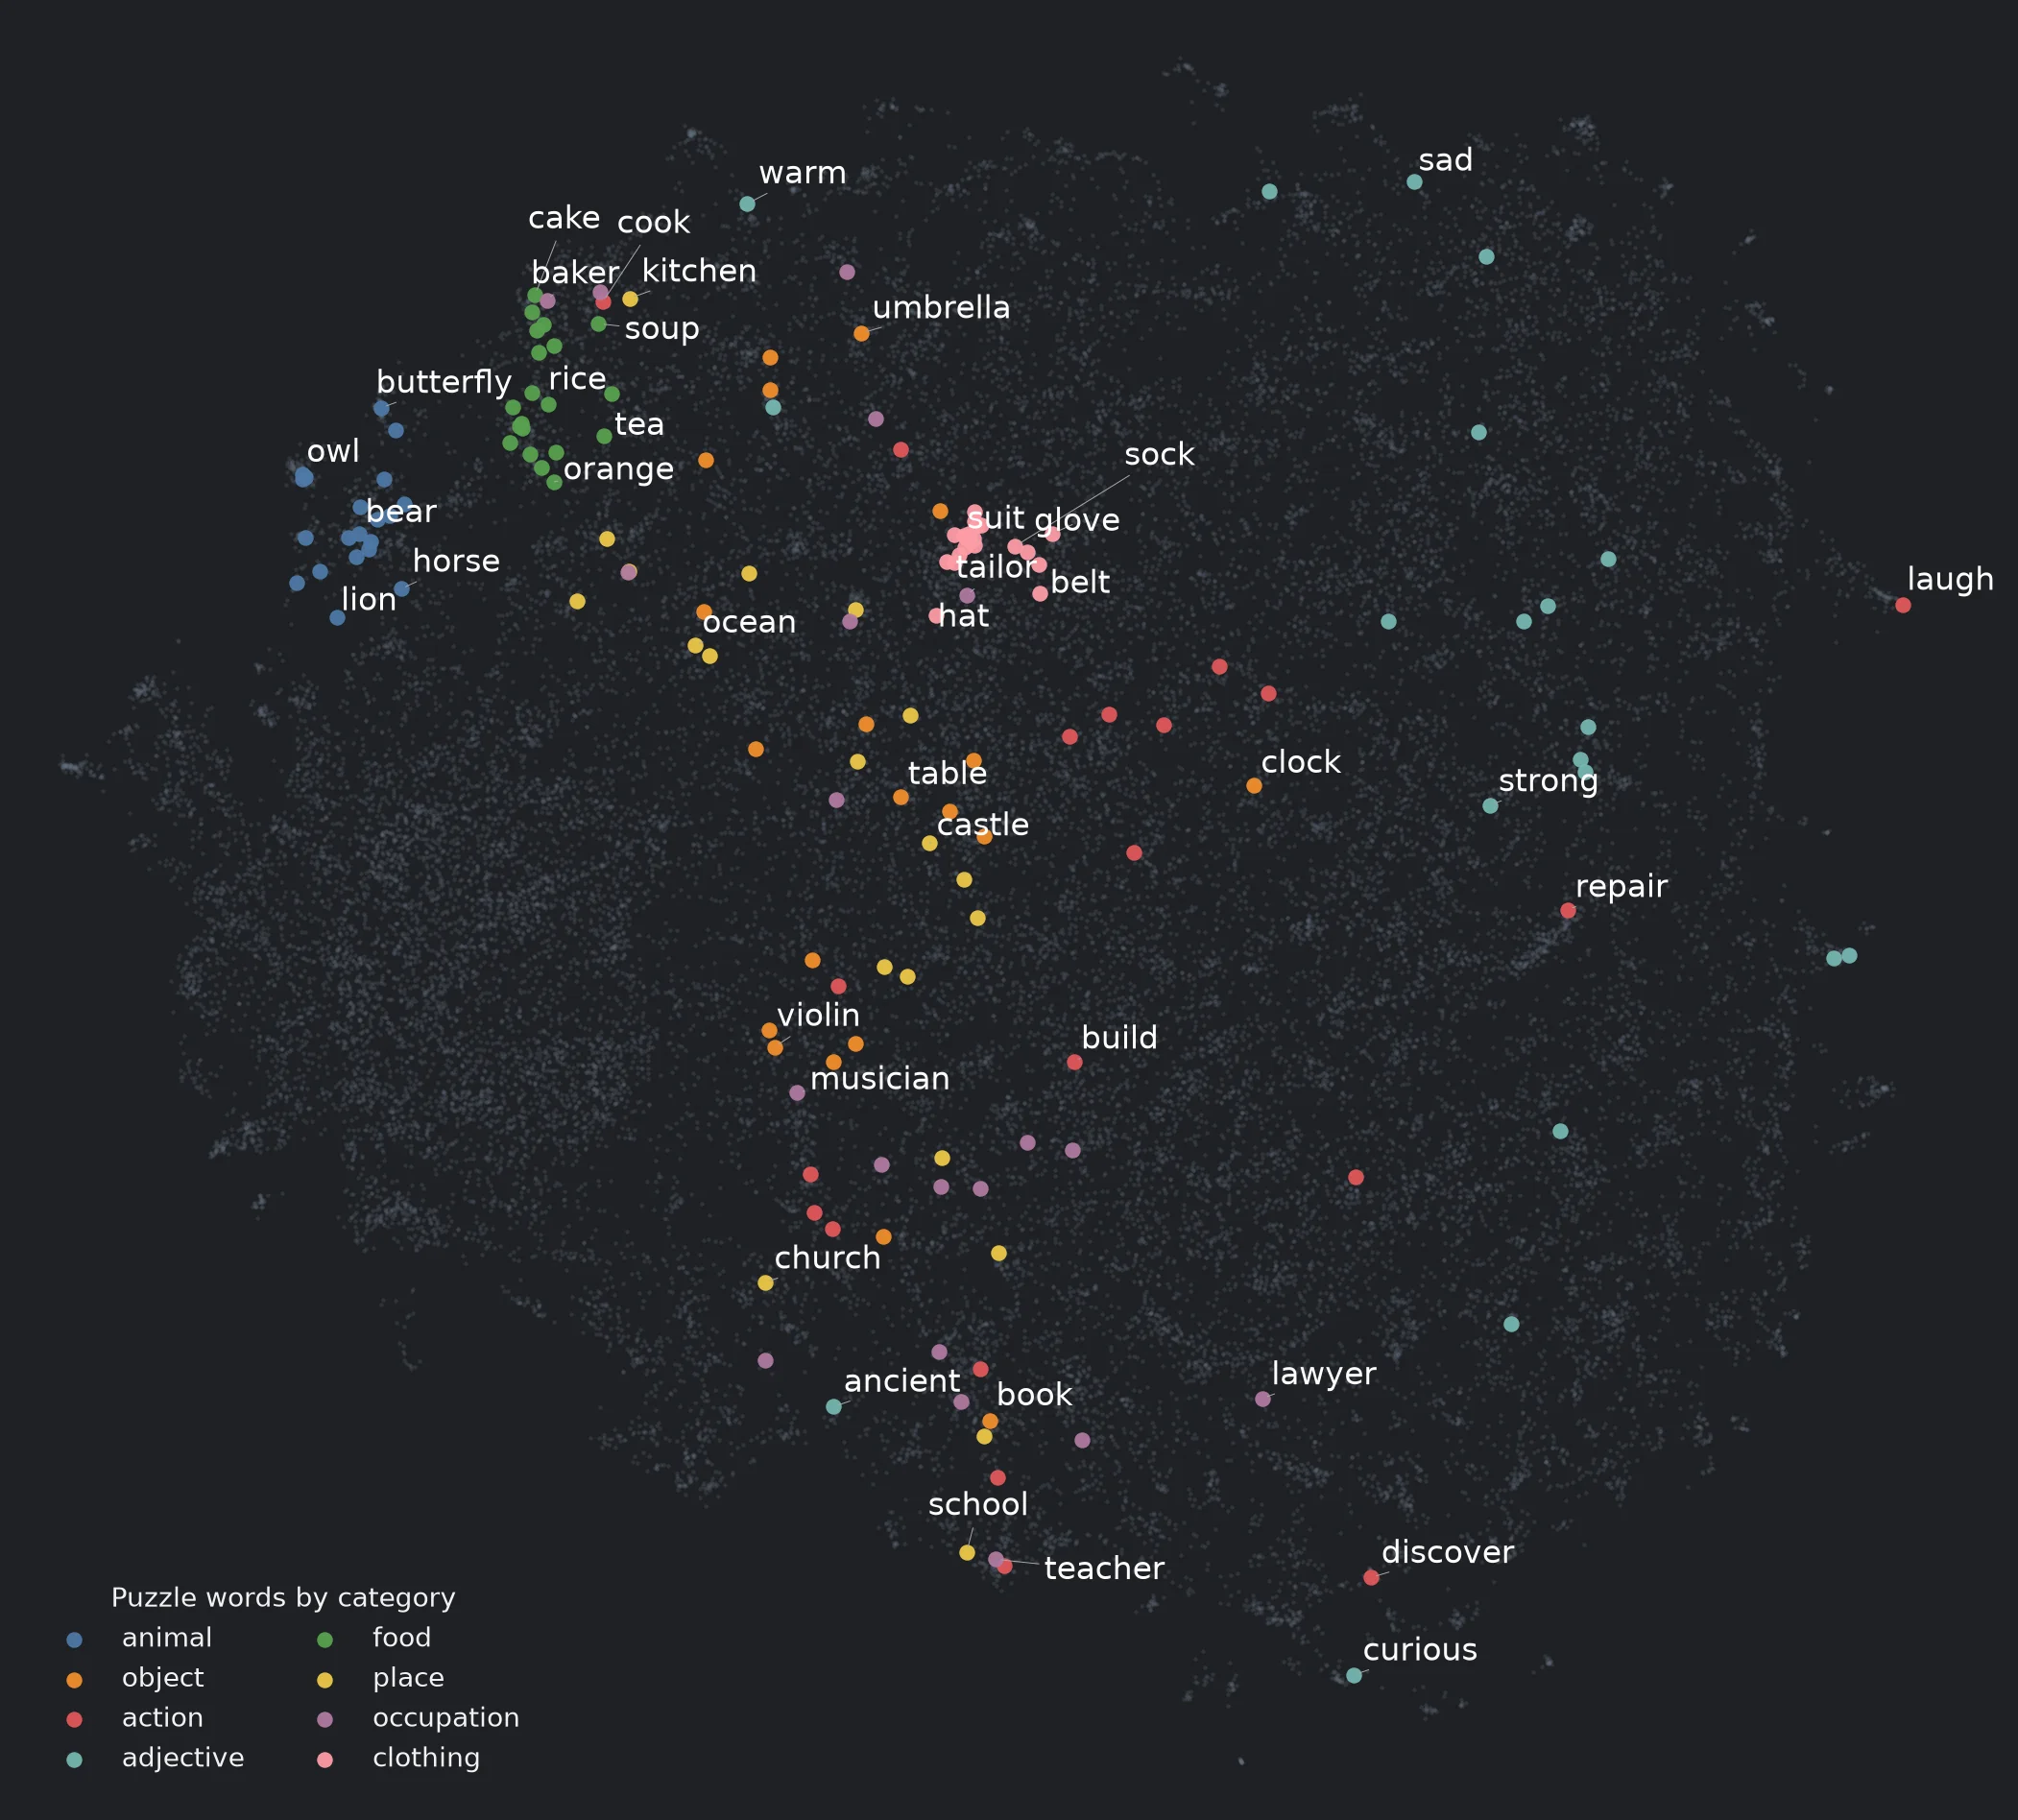
UMAP kabaca temsil uzayını düşük boyutlu uzayda noktaların etkileşmesi açısından görselleştirmemizi sağlar. Mesafeler gerçek mesafeleri tam olarak yansıtmasa da, görsel olarak aynı kategoriden üretilen bulmacaların birbirlerine yakın olduğunu görebilmekteyiz. Bu food ve animal gibi somut örnekler için en çok geçerli olup, daha soyut olan adjective ve action sınıflarının daha dağınık bir yapıya sahip olduğunu görmemizi sağlıyor.
Bir yorum olarak object sınıfının dağınıklığını göz önünde bulundurarak, kolaylaştırmak için ileride bu kategoriyi belki daha alt kategorilere ayırmak mantıklı olabilir diye düşünüyorum.
Bulmaca üretme aşaması
Yukarıdaki aşamalardan sonra bulmaca üretme de basit bir zincirden ibaret oluyor:
graph TB
    A[1. Sözlükten geçerli bir kelime seçme] --> B[2. Kelimenin gösterimini bulma] --> C[3. Diğer kelime gösterimleriyle benzerlik hesaplama] --> D[4. Aday kelimelerin sıralamasını hesaplama ve bulmacayı kaydetme]
Bütün gösterimleri önceden hesaplayıp sakladığımız için, puzzle üretmek bu aşamada oldukça hızlı oluyor. İngilizce bulmacalar için EmbeddingGemma-300m (Vera et al., 2025) gösterim üretme modelini kullanıyoruz çünkü hem hafif, hem güçlü, hem Türkçe desteğine sahip, hem de anlamsal benzerlik (semantic similarity) görevi ile eğitilmiş bir model.
Bu zamana kadar özellikle Türkçe bulmaca konusunu özellikle açmadım, çünkü bu konuya birazdan geri döneceğiz.
Uygulama önyüzü
wordsim’in önyüzü (frontend), üretilen bulmacaları sistemden okuyup servis etme, kullanıcı arayüzünün durumunu yöneterek oyun mantığını kontrol etme gibi görevlere sahip olup aynı zamanda kategori-bazlı filtreleme, kullanıcı girdileri temizleme, ve siteye giriş-çıkış aşamalarında oturum yönetme gibi önemli rollere sahip.
Ayrıca kullanıcı oyun tecrübesini daha iyileştirme ve akıcı bir hizmet sunmak için
- Bulmaca ipuçları ve tutorial kısımlarını sunma
- Kategori-bazlı filtreleme ve ilerleme
- Diller arası çevirileri düzenleme
gibi saymayı unuttuğum başka özelliklere de sahip. Açıkçası önyüzü bu aşamaya getirmek ve saydığım özellikleri katmak, arka plandaki kelime temsili ve benzerlik hesaplama konularından daha fazla emek gerektirdi. Önyüze daha detaylı vakit ayırmak isterdim ama, oyunun ve bu yazının kalbi olan anlamsal kelime benzerliği konusundan devam etmemiz gerekiyor.
Türkçe konusuna hemen geri dönelim.
Türkçe desteği
Bu kısım yabancı okuyuculara Türkçe’yi tanıtmak amaçlı olsa da tekrarlamanın faydalı olduğunu düşünüyorum.
Türkçe, İngilizce’ye göre çeşitli sebeplerden dolayı çok farklı bir dil. Cinsiyetli zamirler yok, Özne-nesne-yüklem sıralaması farklı, yabancıları gerçek bir sınava sokan bir karakter seti ve kendine özgü kuralları var.
Ama bu yazı özelindeki en büyük farkı şu: Türkçe oldukça çekimli (agglutinative) bir dil.
Bu şu anlama geliyor, Türkçe belli bir kelimeyi bağlamsal açıdan zenginleştirmek için çeşitli ekler kullanıyor, ingilizcede bu işlev için ayrı kelimeler kullanıyoruz. Görece normal sayılabilir kelime örnekleri olarak
farklılaştırmak fark-lı-laş-tır-mak
kalabilseydiler kal-a-bil-se-(y)-di-ler
gibi kelimeleri gerektiği zaman kullanmak oldukça doğal. Burada önemli olan şu: bu çekimli yapı dilimizde oldukça yaygın, ve bu sistemi birkaç farklı yönden etkiliyor.
Devam eden kısımda bu projeyi geliştirirken gördüğüm bazı vakalar hakkında inceleme yapalım.
EmbeddingGemma kullanalım?
Dikkatli okuyucumuz, özellikle Türkçe desteği de bulunan EmbeddingGemma model ailesini kullandığımızı hatırlıyor olabilir (tebrikler!). İngilizcede kullandığımız modeli aynı şekilde burada da kullanmayı düşünebiliriz, sonuçta desteği var.
Ancak, göreceğimiz üzere bu destek bizim kullanım alanımız için yeterli değil.
Öncelikle, çekimli kelimeler dilimizde çok yaygın olduğu için, en sık Türkçe kelimeler listelerinde de birçok çekimli kelime var.
Örnek olarak “ev” ve “koşmak” gibi oldukça yaygın iki kelimeyi düşünelim:
| ev (house) | koşmak (to run) |
|---|---|
| evi (his/her house) | koş (run - imperative) |
| evler (houses) | koşuyorlar (they are running) |
| evde (at home) | koştum (I ran) |
| evsiz (homeless) | koşu (a run / a race) |
| evcil (domesticated) | koşacağım (I will run) |
| … | … |
Bu kelimelerin hepsinin aday kelime olarak yer alması büyük bir sorun: kelime dağarcığımızın önemli bir kısmının “aynı kelimenin çekimli arkadaşları” olmasını istemiyoruz. Ancak bazı kelimelerin çekimlerini çıkarıp atsak kurtulabilecek olsak da, özellikle yapım eki içeren kelimeler dilimizde kök kelimeden farklı ve zengin anlamlara sahip. Çözümü ne acaba?
Önişleme. Preprocessing de dediğimiz bu aşamada normalizasyon ve benzeri aşamalar eklemeliyiz ki kelime dağarcığımız benzer kelimeleri çıkarırken önemli kelimeleri atmasın. wordsim burada zemberek-nlp projesinin Python portu olan zeyrek paketini kullanıyor (teşekkürler!). En sık Türkçe kelimeler listesini topladıktan sonra her kelimeyi morpholojik açıdan inceliyoruz. Çoğul/kip/iyelik gibi ekleri temizleyip, özel isimleri kaldırıp, fiilleri mastar haline getirmek gibi aşamalardan geçiriyoruz.
Sıradaki problemimiz oldukça ilginç.
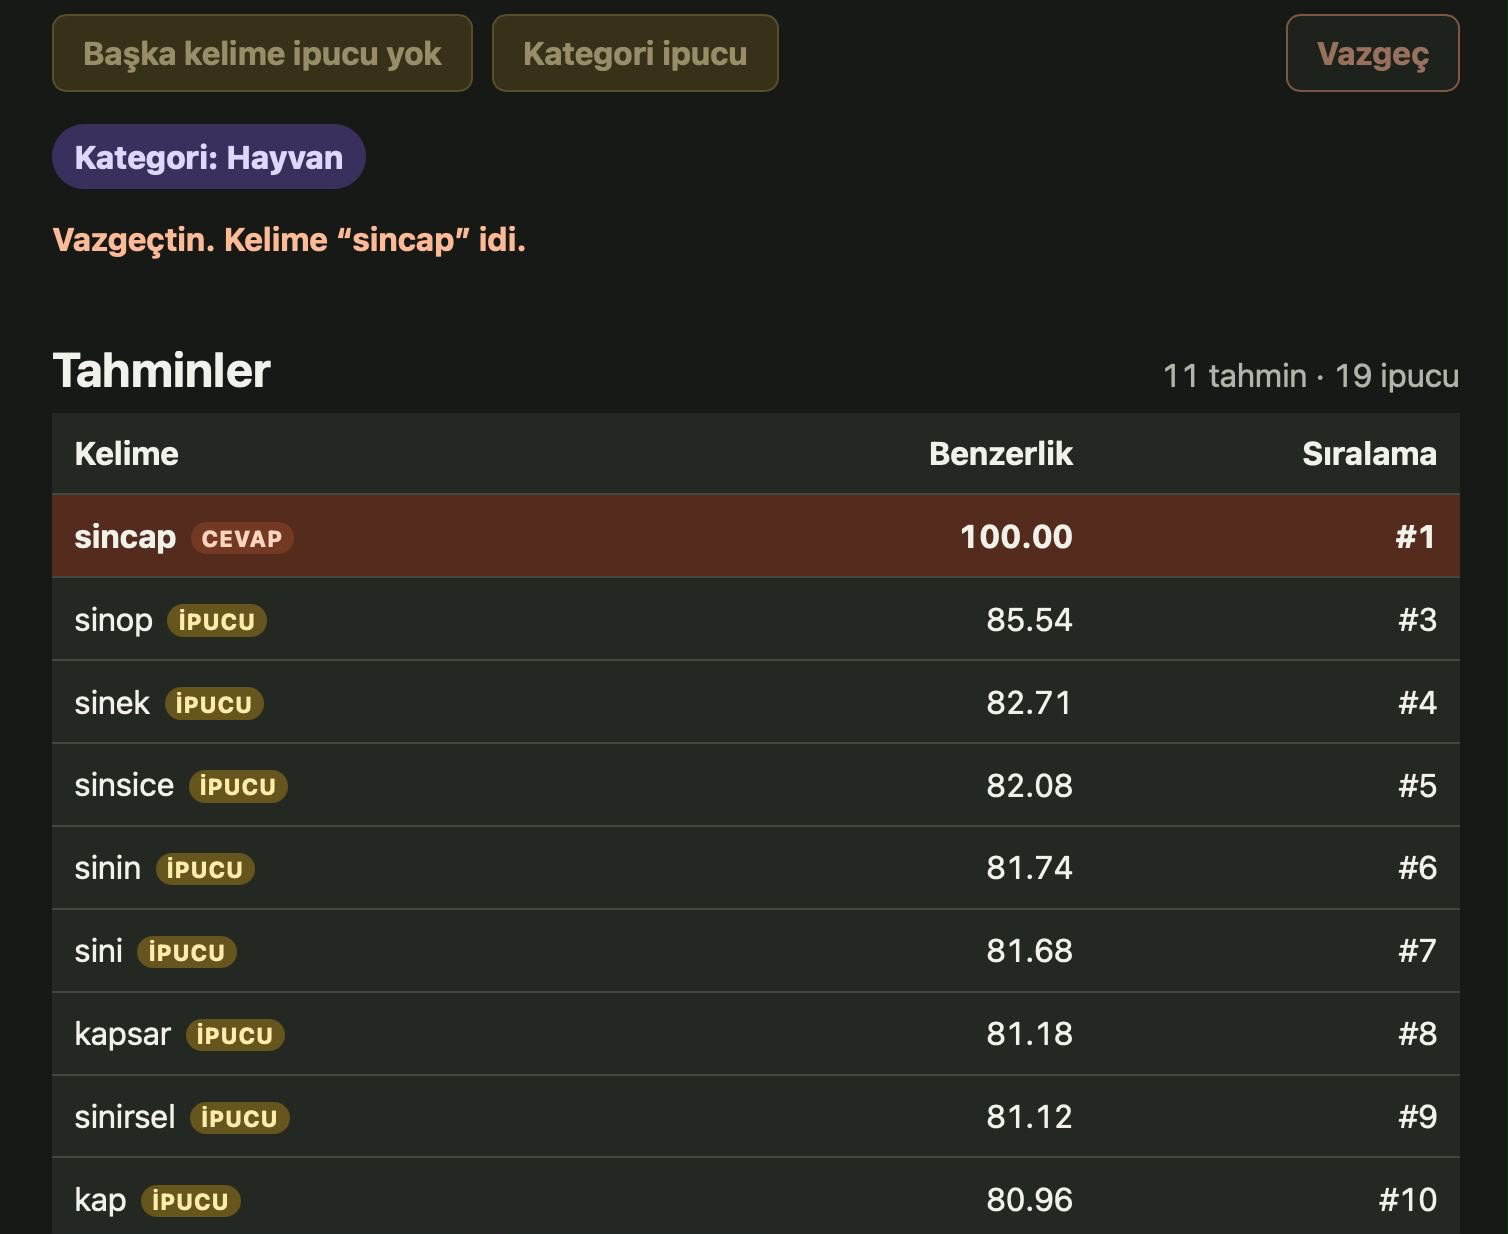
Bu komşu kelimelerin hedef kelime ile anlam olarak hiçbir alakası yok, ancak yüksek benzerlik hesaplanıyor. Ancak, görsel olarak incelediğimizde görüyoruz ki modelimiz arkada kelimeye aslında “parça” olarak benzeyen kelimeler bulmuş. Neden acaba?
Tokenizasyon. “Token”lere3 ayırma işlemi, kelime ve cümleleri bir modelin anlayacağı şekilde anlamlı bölütlere ayırmaya deniyor. Tokenler burada harf olabilir, kelime olabilir, subword (sözcük bölütü) olabilir (hatta görsel Transformerlar için görüntü kesitleri olabilir), ve model tokenleri işledikçe cümleye ait olan bağlamları modelleyip cümlenin gösterimini özelleştirir. Örnek olarak OpenAI’ın tokenizer sistemine bakılabilir.
Burada bence iki adet olası durum var: model Türkçe bağlamında sin ve cap olarak iki parçaya ayırdığı bu kelimeyi düzgün yorumlayamıyor. Hatırlarsak EmbeddingGemma çok dilli bir model, ve üstüne sin ve cap İngilizcede birer gerçek kelimeye karşılık geliyor: kelimeyi “günah” ve “şapka” olarak yorumlayıp kemirgen arkadaşımızı tamamen ıskalıyor olabilir. Alternatif olarak, daha genel düşünürsek model Türkçe konusunda yüzeysel bilgiye sahip olduğu için ve eğitiminde İngilizce’ye kıyasla bir dengesizlik olduğu için, Türkçe kelimeler konusunda iyi bir gösterim uzayı öğrenememiştir belki: bu yüzden de kelimeleri sadece hece veya ek zinciri düzeyinde işliyor olabilir.
Alttaki yatan sebebin ne olduğunu bilmiyorum maalesef, ancak bu problemi başka araştırmacıların da gözlemlediğini görüyoruz (Bayram et al., 2026). Bu konuda daha hassas bir model olarak EmbeddingMagibu-200m modelini kullanmayı denedim; bu sorunu bir miktar çözüyor olsa da maalesef wordsim Türkçe bulmacalarında bu problemi tamamen çözme konusunda sınırlı etkisi oldu.
Son olarak, Türkçe problemlerde gördüğüm başka bir problem olarak şu durum benim çok ilgimi çekti.
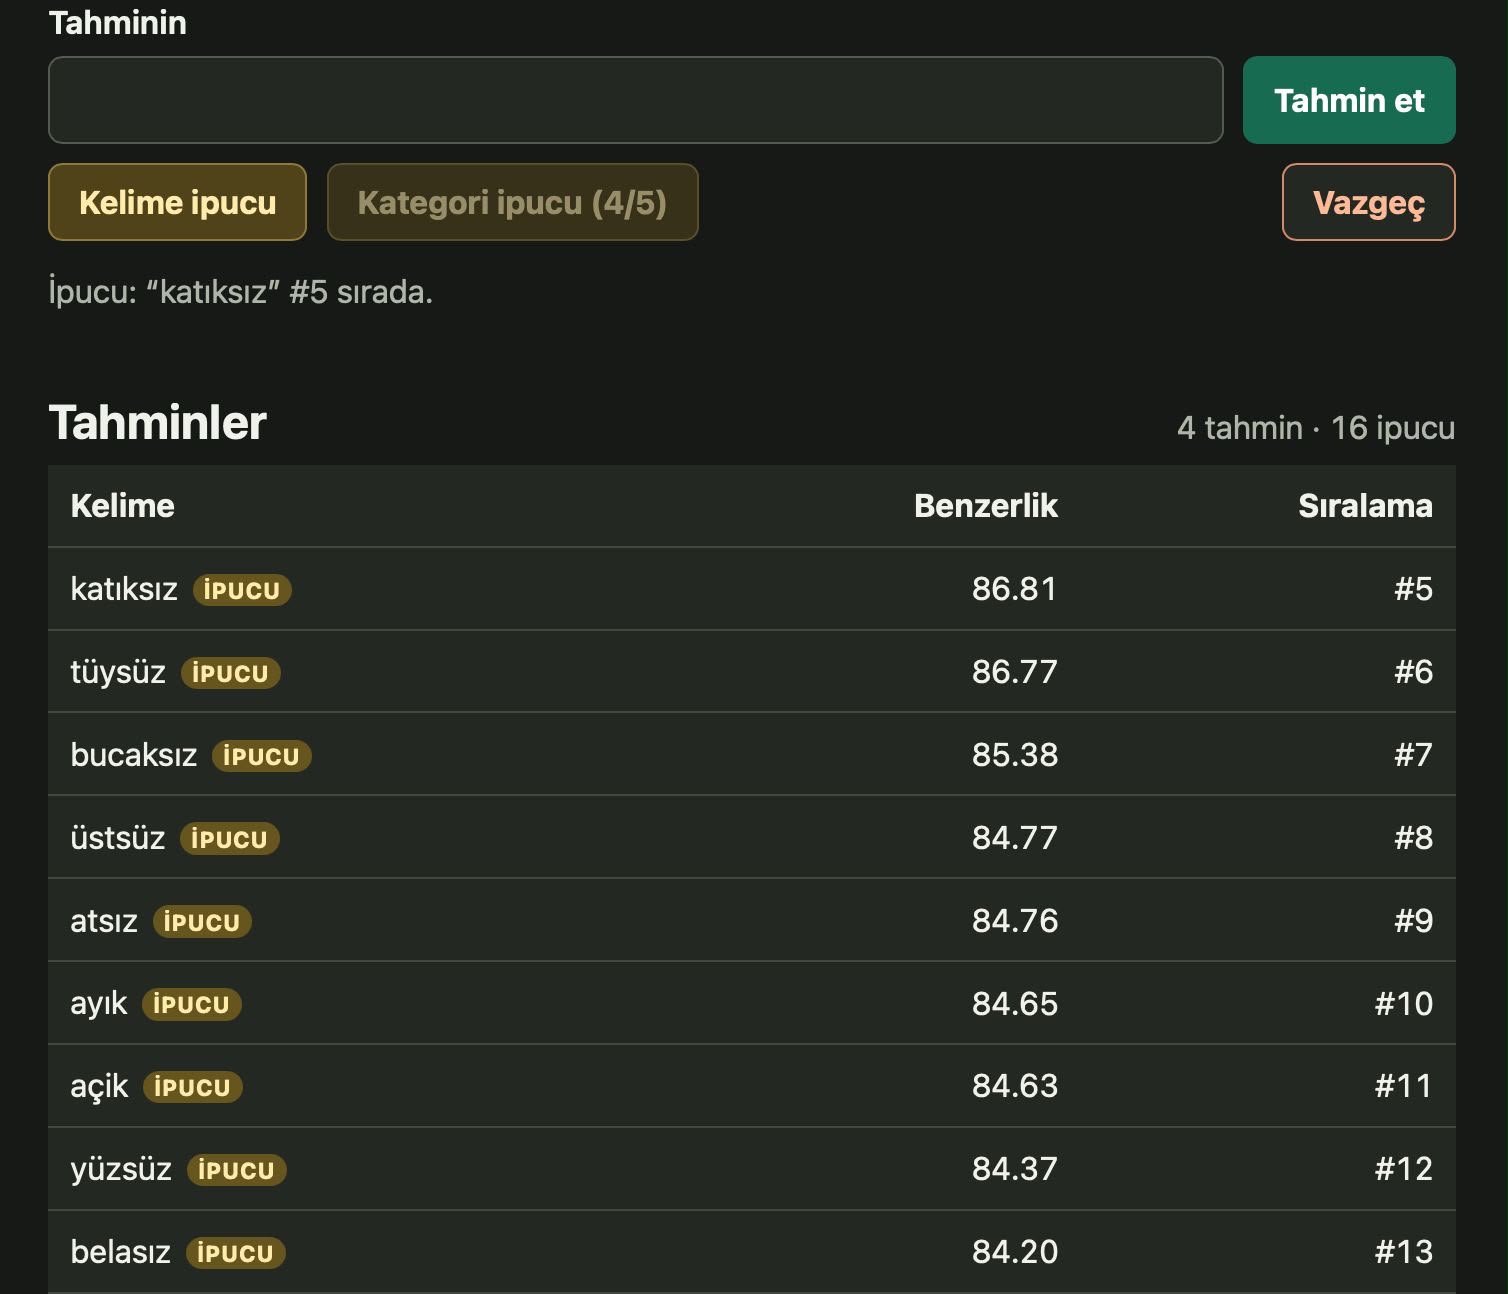
Modelimiz burada “ıssız” kelimesi için anlamca yakın olabilecek kelimeler yerine eksiklik içeren başka sız/siz ekli kelimeler buluyor.
Burada önemli bir husus olarak “-sız/-siz” bir yapım eki olması sebebiyle kendilerini kelime dağarcığından çıkarmak istemiyoruz.
Ancak bu konu bence kendi içinde farklı bir durum: Modelin benzerlik sonuçları aslında beklendiği gibi çalışıyor, yani bu kelimeler gerçekten bir anlama göre yakın. Sorun şu ki yanlış yönde anlamsal benzerlik üzerinden gidiyoruz: İngilizce’de belki bir örnek olarak “without air” da “without water” kavramına yüksek benzerliğe sahip olacaktı. Tabii, alternatif olarak belki de önceki soruna da bağlantılı olup modelimiz “sız” tokenine göre benzerliğe odaklanıyor olabilir.
Modeli bu konuda iyileştirmek için ya gösterim uzayını şekillendirecek bir objektife, ya oluşan uzayı bu yönde benzerlik hesaplamasını “istediğimiz benzerliğe” odaklanacak şekilde değiştirmeye, ya da “sız” tokeninin ağırlığını hafifletcek şekilde modeli değiştirmeye ihtiyacımız var.
Literatüre yine bakıldığında Türkçe’de anlamsal benzerlik açısından bu problemin de daha önce gözlemlendiğini görüyoruz (Sarıtaş et al., 2024). Bu doğrultuda anlamsal benzerlik görevi özelinde word2vec bazlı gösterimlerin, BERT-bazlı dil modellerine kıyasla daha etkili olabileceğini okuduktan sonra Türkçe için kullandığımız modeli skip-gram yöntemiyle eğitilen word2vec vektörleri olarak değiştirdim.
Bu sayede bu kısımda bahsettiğimiz Türkçe eklere özgü problemlerin büyük ölçüde azaldığını gözlemledim. Türkçe bulmacaların ek benzerliğinden hesaplanan yanlış komşu kelime miktarı önemli derecede azaldı, ancak gözlemlediğim üzere Türkçe bulmacalar da İngilizce’ye kıyasla biraz daha zor oldu.
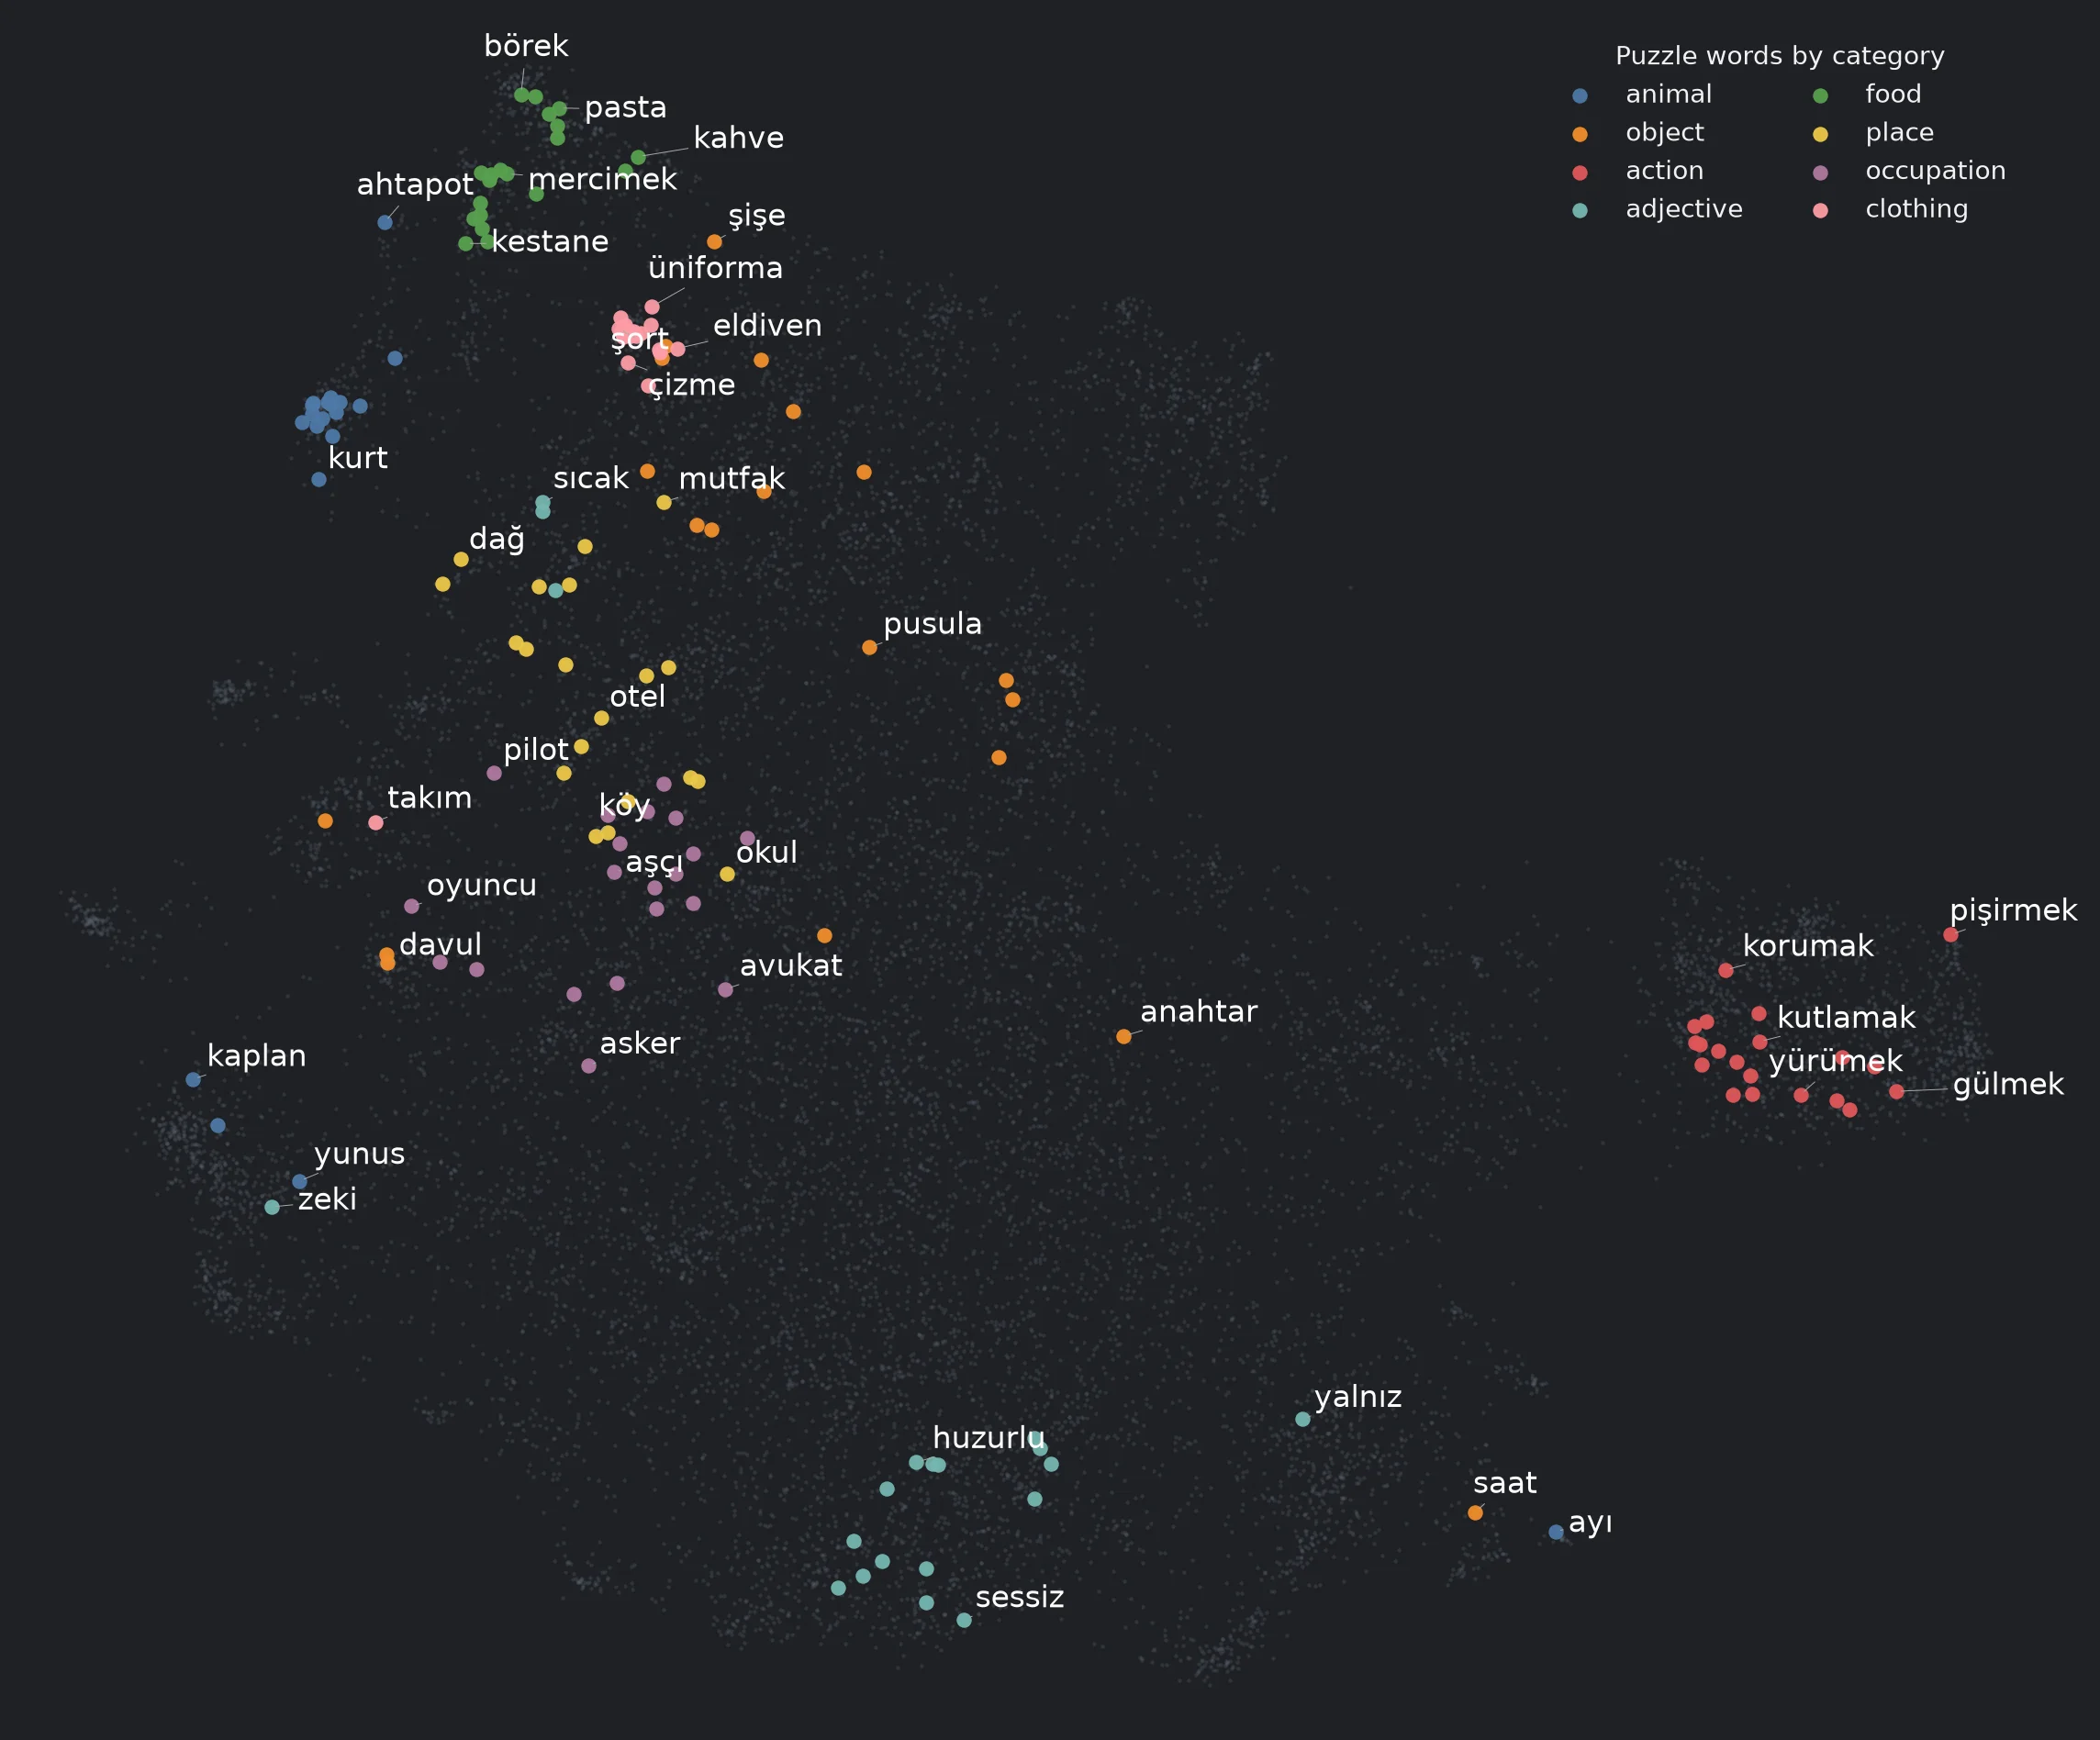
Son olarak, İngilizce’de de baktığımız şekilde Türkçe kelime gösterimlerinin UMAP projeksiyonlarına bakabiliriz. Şu figürü girişte görmüştük, tekrar hatırlayalım:
İngilizce ile karşılaştırdığımızda kategoriler arasındaki genel bağıntıların Türkçe’de de korunduğunu görüyoruz. Oldukça ilginç bir şekilde, fiillerin tamamen kendi bir geometrileri olduğunu görüyoruz, fiillerin yakın kelimelerin başka fiiller olmasının bir sebebi de bu olmalı. Buradaki sonuçlar kelimelerin word2vec gösterimi olmasına rağmen İngilizce’deki transformer-bazlı gösterim modeline benzer olan bir görsel çıkıyor olması da bence ilginç.
Genel olarak, Türkçe modelini iyileştirmeye çalışmaya devam ediyorum.
wordsim için sıradaki adım ne?
Bu yazı içerisinde konuşamadığımız bazı parametreler var. Bunlardan bir tanesi gösterim boyutu, yani kelimelerin gösterimlerinin yer aldığı uzayın belirlenen boyutu. İngilizce’deki gösterim boyutu $d_\mathrm{temsil} = 768$, yani kelimeler 768-boyutlu bir uzay içerisinde temsil ediliyorlar. Peki burada bu boyutun etkisi ne?
- Boyutu azaltmak, uzayı küçülttüğünden dolayı bağlam kapasitesini ve benzerliği kötü etkiliyor mu?
- Boyutu arttırmak, yüksek boyutlarda uzaklık ölçütlerinin karakterinden nasıl etkileniyor?
Başka bir örnek olarak dil modelleri için kelimelerin düz temsili ile prompt-bazlı (yönlendirmeli) temsili arasında nasıl bir ilişki olduğuna bakmak istiyorum.
Onun dışında bahsettiğim üzere, daha keyifli bir oyun sunmak için kullanılan Türkçe modeli iyileştirmeyi hedefliyorum. Oyun daha geniş bir kitleye ulaşsın diye de yakın zamanda başka diller eklemeyi hedefliyorum.
Projeye ortak olmak isterseniz, kodu GitHub üzerinden ulaşılabilir. Önerilerinizi, katkılarınızı, şikayet ve oyunu oynarken yaşadığınız sorunlarınızı oradan veya e-mail üzerinden iletebilirsiniz.
-
Yazı içerisinde “representation” kelimesine karşılık olarak değişmeli olarak “temsil” ve “gösterim” kelimelerini kullanıyor olacağım. Aynı şekilde, “sözcük” ve “kelime” bu bağlamda eş kelimeler. ↩
-
“embedding” doğrudan “gömme” diye çevriliyor. Kelimeleri bu yeni uzaya bir anlamda gömüyor olsak da “temsil” veya “gösterim” sanki daha hoş oluyor. ↩
-
“Jeton” diye de çevrildiğini gördüm. Transformer bağlamında bazen çok yanlış hissettirmese de sanki “token” daha iyi bir seçenek. ↩
References
- Radford, A., Kim, J. W., Hallacy, C., Ramesh, A., Goh, G., Agarwal, S., Sastry, G., Askell, A., Mishkin, P., Clark, J., & others. (2021). Learning transferable visual models from natural language supervision. International Conference on Machine Learning, 8748–8763.
- Bengio, Y., Ducharme, R., Vincent, P., & Janvin, C. (2003). A Neural Probabilistic Language Model. J. Mach. Learn. Res., 3, 1137–1155. https://jmlr.org/papers/v3/bengio03a.html
- Mikolov, T., Sutskever, I., Chen, K., Corrado, G. S., & Dean, J. (2013). Distributed Representations of Words and Phrases and their Compositionality. In C. J. Burges, L. Bottou, M. Welling, Z. Ghahramani, & K. Weinberger (Eds.), Advances in Neural Information Processing Systems (Vol. 26). Curran Associates, Inc.
- Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, L., & Polosukhin, I. (2017). Attention Is All You Need. CoRR, abs/1706.03762. http://arxiv.org/abs/1706.03762
- Radford, A., Narasimhan, K., Salimans, T., & Sutskever, I. (2018). Improving Language Understanding by Generative Pre-Training. OpenAI. https://cdn.openai.com/research-covers/language-unsupervised/language_understanding_paper.pdf
- Devlin, J., Chang, M.-W., Lee, K., & Toutanova, K. (2019). BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. Proceedings of the 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, Volume 1 (Long and Short Papers), 4171–4186. https://doi.org/10.18653/v1/N19-1423
- Vera, H. S., Dua, S., Zhang, B., Salz, D., Mullins, R., Panyam, S. R., Smoot, S., Naim, I., Zou, J., Chen, F., & others. (2025). Embeddinggemma: Powerful and lightweight text representations. ArXiv Preprint ArXiv:2509.20354.
- Bayram, M. A., Diri, B., & Yıldırım, S. (2026). Adapting Multilingual Embedding Models to Turkish via Cross-Lingual Tokenizer Surgery and Offline Distillation. ArXiv Preprint ArXiv:2605.29992. https://arxiv.org/abs/2605.29992
- Sarıtaş, K., Öz, C. A., & Güngör, T. (2024). A comprehensive analysis of static word embeddings for Turkish. Expert Systems with Applications, 252, 124123. https://doi.org/https://doi.org/10.1016/j.eswa.2024.124123